2025年7月18日,由广东省图象图形学会主办,GDSIG计算机视觉专委会承办的《多模态内容理解与生成》分论坛于2025中国空间智能大会(ChinaSI)期间在深圳市云谷光明国际会议厅B厅成功举办。现场气氛热烈,吸引了来自全国各地高校、科研机构以及相关企业的多位专业人士参会,共同聚焦多模态内容理解与生成领域的前沿动态。
本次论坛由广东省图象图形学会(GDSIG)计算机视觉专委会主任、中山大学李冠彬教授主持,并特别邀请到三位青年学者—香港科技大学罗文寒副教授、哈尔滨工业大学(深圳)邵睿教授以及中山大学胡建芳副教授,分享各自在多模态内容理解与生成领域的前沿研究成果。
图1. 中山大学李冠彬教授主持
首先由香港科技大学罗文寒副教授带来题为“Towards Controllable Content Generation” 的报告。罗文寒目前是香港科技大学副教授,曾在中山大学担任副教授、在腾讯担任应用研究科学家,还曾于加州帕洛阿尔托的亚马逊任职。他于2016 年获伦敦帝国理工学院博士学位,2012 年获中国科学院自动化研究所硕士学位,2009 年获华中科技大学学士学位。发表超100篇经过同行评审的论文,其成果融入微信、QQ 等腾讯产品中,荣获 CVPR 2019 最佳论文决赛奖、2022 ACM 中国新星奖(广州分会)等荣誉,同时担任多个期刊编辑和会议领域主席,并入选斯坦福 / 爱思唯尔评选的全球前2% 科学家(2023 年和2024 年)。
图2.香港科技大学罗文寒副教授作报告
罗文寒副教授的报告聚焦 AI 驱动内容创作的最新进展,围绕增强文本、图像和视频生成的可控性展开。报告介绍了多种创新方法,如分离外观和运动的视频超分辨率技术、不破坏提示一致性的面部个性化定制方法、精确音频绑定的多人对话视频合成技术等。这些研究借助新颖调节策略、分离技术和基础模型知识,实现生成式 AI 的细粒度控制。
接着由哈尔滨工业大学(深圳)邵睿教授作 “基于多模态大模型的虚实智能体技术研究与应用”的报告。邵睿教授是哈尔滨工业大学(深圳)计算机科学与技术学院教授、博士生导师,入选国家级青年人才计划,是华为战略研究院人才 Funding 获得者。主要研究多模态大模型、具身智能,以第一作者/ 通讯作者身份发表近 40 篇高水平论文,主持或参与多项国家级和省市项目,担任多个顶级会议主席,现负责构建哈工大深圳 “九天” 多模态大模型。
图3.哈工深邵睿教授作报告
邵睿教授的报告简要剖析了各类大模型的崛起与现状,介绍了哈工大(深圳)自主研发的“感知 – 理解 – 决策” 三元协同的 “九天” 多模态大模型。基于该模型的多模态能力,重点阐述虚拟助手智能体与具身智能机器人这两个领域的智能体技术研究,展示多模态大模型在数字世界与物理世界的实际作用。
最后由中山大学胡建芳副教授带来题为 “细粒度视频 – 文本跨模态语义对齐与建模” 的报告。胡建芳副教授是中山大学博士生导师,主要从事视频时空特征学习理论及应用研究,在多模态视频理解及生成方面取得一系列理论和应用成果,发表学术论文 60 余篇,主持或参与十余项项目,曾获广东省自然科学奖二等奖等荣誉,还多次在国际学术竞赛中获奖。
图4. 中山大学胡建芳副教授作报告
胡建芳副教授的报告聚焦跨模态语义对齐与多模态联合建模,由于缺乏细粒度视频–文本标注的训练数据,现有多模态模型在细粒度跨模态语义对齐方面表现欠佳。此次报告介绍了其课题组在该领域的近期研究工作,重点展示了相关模型在基于文本描述的视频定位和视频内容分割等多模态理解任务中的表现,分享了近期收集的视频分割和长文本长视频理解数据集等。
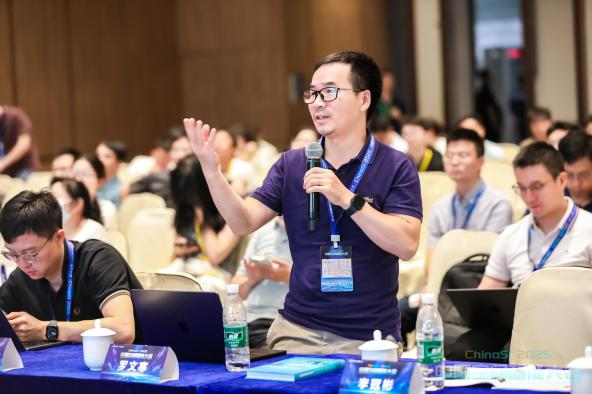
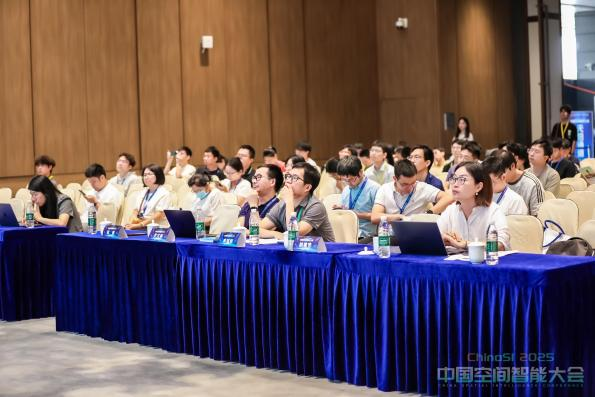
图5.论坛现场讨论热烈
图6.广东省图象图形学会(GDSIG)计算机视觉专委会秘书处成员与论坛嘉宾合影
本次论坛汇聚了多模态内容理解与生成领域的多位青年学者做最新科研成果的分享报告,不仅拓宽了参会者的学术视野,更为未来的研究与合作搭建了广阔桥梁。
文/图 崔金荣
审核:李冠彬