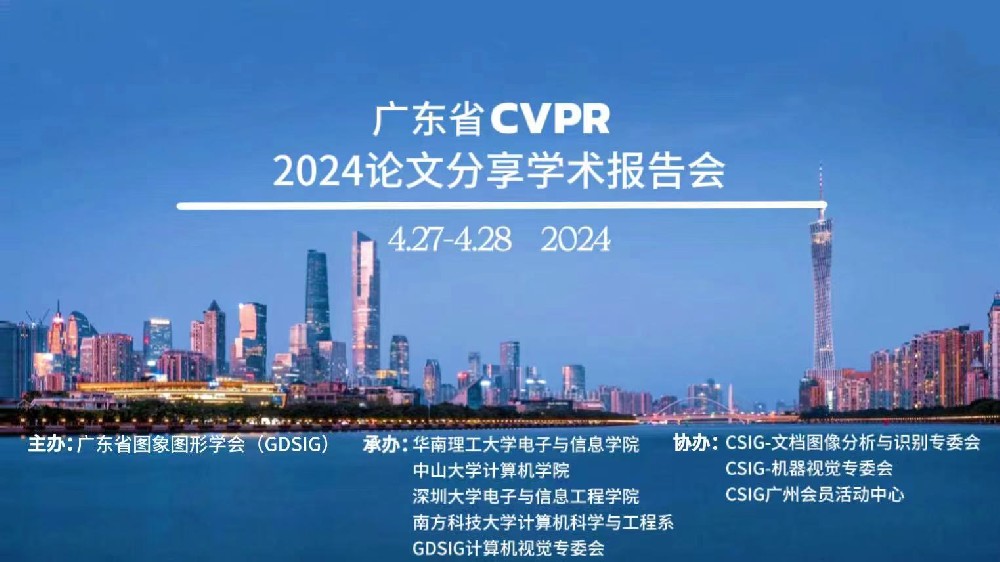
主办:
广东省图象图形学会(GDSIG)
承办:
华南理工大学电子与信息学院
中山大学计算机学院
深圳大学电子与信息工程学院
南方科技大学计算机科学与工程学院
GDSIG计算机视觉专委会
协办:
CSIG-文档图像分析与识别专委会
CSIG-机器视觉专委会
CSIG广州会员活动中心
时间:
2024年4月27日(星期六)8:50-17:20
2024年4月28日(星期日)9:00-12:10
直播平台:
GDSIG视频号
B站平台:https://live.bilibili.com/27738963
蔻享学术:https://www.koushare.com/live/details/33662
国际计算机视觉与模式识别会议(IEEE International Conference on Computer Vision and Pattern Recognition, CVPR)作为IEEE年度旗舰盛会,不仅是全球最顶尖的计算机视觉学术平台之一,更是全球科技界高度关注的创新高地。在不断推陈出新的科研浪潮中,CVPR上发表的研究成果不仅深刻影响着相关领域的知识体系构建,更为全球科研人员提供了极具价值的创新启示与实践指导。
根据最新的Google学术指标(Google Scholar Metrics),CVPR在全球学术出版物中位列第4,紧随Nature、The New England Journal of Medicine、Science之后。在中国计算机学会推荐的国际学术会议体系中,CVPR稳居人工智能领域A类之列。
值此CVPR 2024盛会即将启幕之际,我们特别策划了一场线上分享会,诚邀来自广东省内各优秀研究团队的29位青年才俊,介绍他们今年被CVPR 2024录用论文的研究成果。
会议日程一览表
|
2024年4月27日上午 (会议主持人:丁长兴、陈昌盛) |
||
|
时间 |
报告题目 |
论文第一作者,导师/通信作者 |
|
8:50-9:00 |
会议开幕致辞 |
赖剑煌教授 |
|
论文主题:识别与分割 (10 篇) |
||
|
9:00–9:20 |
View-decoupled Transformer for Person Re-identification under Aerial-ground Camera Network 基于视角解耦自注意力模型的空地行人重识别方法 |
张权,赖剑煌 |
|
9:20–9:40 |
Multi-scale Dynamic and Hierarchical Relationship Modeling for Facial Action Units Recognition 基于多尺度动态和层次关系建模的面部动作单元识别 |
汪子晗,沈琳琳 |
|
9:40-10:00 |
BigGait: Learning Gait Representation You Want by Large Vision Models 大步态: 从视觉大模型中学到你想要的步态特征 |
Dingqiang Ye, 于仕琪/刘晓明 |
|
10:00-10:20 |
AlignSAM: Aligning Segment Anything Model to Open Context via Reinforcement Learning 利用强化学习将分割一切模型对齐到开放语境 |
黄铎峻,李冠彬 |
|
10:20-10:40 |
Bridging the Gap Between End-to-End and Two-Step Text Spotting 缩小端到端文本识别和两阶段文本识别的差距 |
黄明鑫,金连文 |
|
10:40-11:00 |
APSeg: Auto-Prompt Network for Cross-Domain Few-Shot Semantic Segmentation APSeg: 用于跨域小样本语义分割的自动提示网络 |
何伟钊, 张洋/卓炜 |
|
11:00-11:20 |
DiffForensics: Leveraging Diffusion Prior to Image Forgery Detection and Localization DiffForensics: 将扩散先验用于图像篡改检测与定位 |
余泽钦, 倪江群/李斌 |
|
11:20-11:40 |
CMA: A Chromaticity Map Adapter for Robust Detection of Screen-Recapture Document Images CMA:用于鲁棒检测屏幕翻拍文档图像的色度特征图适配器 |
林良威,陈昌盛 |
|
11:40-12:00 |
Towards Modern Image Manipulation Localization: A Large-Scale Dataset and Novel Methods 面向现代风格图像的篡改定位:一个大规模数据集和新颖的方法 |
曲晨帆, 金连文/钟亦武 |
|
12:00-12:20 |
SLearning Background Prompts to Discover Implicit Knowledge for Open Vocabulary Object Detection 通过学习背景提示发现开放词汇目标检测中的隐含知识 |
李佳铭,李冠彬
|
|
2024年4月27日下午(会议主持人:谢晓华、张鑫) |
||
|
时间 |
论文题目 |
论文第一作者,导师/通信作者 |
|
论文主题:内容生成 (10 篇) |
||
|
14:00-14:20 |
Single-View Scene Point Cloud Human Grasp Generation 单视角场景点云人手抓取生成 |
王炎康,郑伟诗 |
|
14:20-14:40 |
Coarse-to-Fine Latent Diffusion for Pose-Guided Person Image Synthesis 由粗到细的潜在扩散用于姿势引导人物图像合成 |
卢彦作, 马锦华/谢晓华 |
|
14:40-15:00 |
Texture-Preserving Diffusion Models for High-Fidelity Virtual Try-On 用于高保真虚拟试穿的保持纹理的扩散模型 |
杨煦,丁长兴 |
|
15:00-15:20 |
360DVD: Controllable Panorama Video Generation with 360-Degree Video Diffusion Model 360DVD:基于360度视频扩散模型的全景视频生成 |
王茜,张健 |
|
15:20-15:40 |
Text-conditional Attribute Alignment across Latent Spaces for 3D Controllable Face Image Synthesis 基于潜空间下文本定义属性对齐的三维可控人脸图像生成 |
徐非凡, 吴斯/李瑞 |
|
15:40-16:00 |
Towards Variable and Coordinated Holistic Co-Speech Motion Generation 面向可变且协调的全身语音动作生成 |
刘翼飞, 丁长兴/曹琼 |
|
16:00-16:20 |
Tackling the Singularities at the Endpoints of Time Intervals in Diffusion Models 解决扩散模型中时间间隔端点的奇异性 |
张鹏泽,谢晓华 |
|
16:20-16:40 |
NeRF-HuGS: Improved Neural Radiance Fields in Non-static Scenes Using Heuristics-Guided Segmentation NeRF-HuGS: 在非静态场景中使用启发式引导分割改进的神经辐射场 |
陈家豪,李冠彬 |
|
16:40-17:00 |
AlignMiF: Geometry-Aligned Multimodal Implicit Field for LiDAR-Camera Joint Synthesis AlignMiF:用于雷达–相机联合合成的几何对齐多模态隐式场 |
唐涛, 梁小丹/于开丞 |
|
17:00-17:20 |
Neural Customizable Human Avatar 可定制化数字人 |
肖俊锦,张青 |
|
2024年4月28日上午(会议主持人:于仕琪、张青) |
||
|
时间 |
论文题目 |
论文第一作者,导师/通信作者 |
|
论文主题:图像恢复与表征学习 (9篇) |
||
|
9:00-9:20 |
VRetouchEr: Learning Cross-frame Feature Interdependence with Imperfection Flow for Face Retouching in Videos VRetouchEr:学习跨帧功能相互依存与不完美流在视频中的面部修饰 |
薛文, 吴斯/许勇 |
|
9:20–9:40 |
CoSeR: Bridging Image and Language for Cognitive Super-Resolution CoSeR:连接图像与语言,实现认知超分辨率 |
Haoze Sun,Yujiu Yang |
|
9:40-10:00 |
Learning to Remove Wrinkled Transparent Film with Polarized Prior 通过偏振先验去除褶皱透明薄膜 |
Jiaqi Tang,Ying-Cong Chen |
|
10:00-10:20 |
Learning Degradation-unaware Representation with Prior-based Latent Transformations for Blind Face Restoration 基于先验的潜变换学习对退化不敏感的表征以实现盲脸恢复 |
谢炼新,吴斯 |
|
10:20-10:40 |
Incremental Residual Concept Bottleneck Models 增量式残差概念瓶颈模型 |
尚辰铭, 杨余久/王玉旺 |
|
10:40-11:00 |
EditGuard: Versatile Image Watermarking for Tamper Localization and Copyright Protection EditGuard:联合篡改定位和版权保护的多功能图像水印 |
张轩宇,张健 |
|
11:00-11:20 |
Deep Unsupervised Unrolling Networks for Phase Unwrapping 针对相位展开的深度无监督展开网络研究 |
陈志乐,全宇晖 |
|
11:20-11:40 |
Latent Modulated Function for Computational Optimal Continuous Image Representation 基于隐调制函数的计算最优连续图像表示 |
何宗耀,金枝 |
|
11:40-12:00 |
Learning Adaptive Spatial Coherent Correlations for Speech-Preserving Facial Expression Manipulation 为保留语音的面部表情操作学习自适应空间一致性关联 |
林坚满,陈添水 |
|
12:00-12:10 |
闭幕式致辞 (金连文教授) |
|
报名注册
1. 本次在线会议免费参加,不收取任何注册费,不用提前报名注册。
2. 普通听众请通过直播网址参加会议。
3. 特邀讲者及嘉宾、GDSIG理事,会议ID另行通知。
组委会
金连文,华南理工大学电子与信息学院
郑伟诗,中山大学计算机学院
张 鑫,华南理工大学电子与信息学院
谢晓华,中山大学计算机学院
张 青,中山大学计算机学院
于仕琪,南方科技大学计算机科学与工程系
陈昌盛,深圳大学电子与信息工程学院
联系人
张老师,Email: eexinzhang@scut.edu.cn
谢老师,Email: xiexiaoh6@mail.sysu.edu.cn