CSIG&GDSIG 2023年学术交流报告会
广东省图象图形学会(GDSIG)换届大会暨中国图象图形学学会(CSIG)广州会员中心成立大会将于2023年3月12日在华南理工大学逸夫人文馆学术报告厅举行。为了促进图形图像处理及人工智能相关领域的学术交流,为CSIG广州分部和GDSIG的广大会员、广东省高校师生和社会专业技术领域人士介绍前沿科学技术研究进展动态,特此举办此次学术交流活动。
时间:2023年3月12日星期日下午14:45–17:00
地点:广州市五山路381号华南理工大学逸夫人文馆学术报告厅
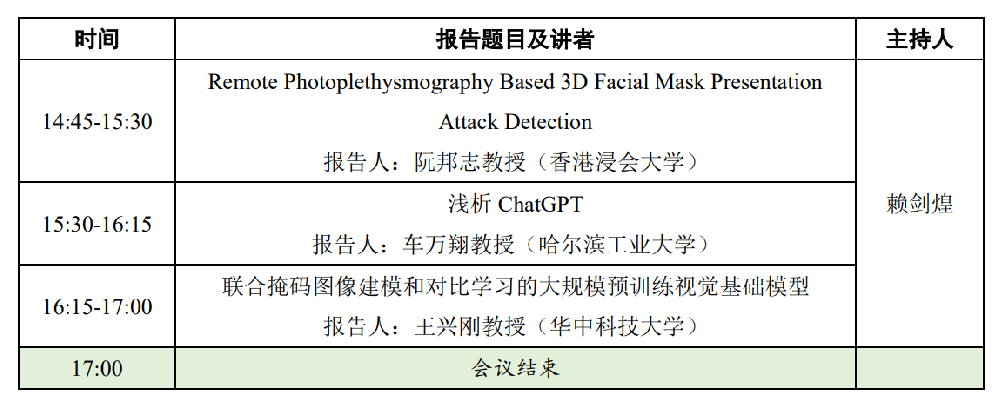
特邀报告1:Remote Photoplethysmography Based 3D Facial Mask Presentation Attack Detection (a.k.a Face Anti-spoofing)
特邀讲者:Pong C Yuen (Professor, Hong Kong Baptist University)
讲者简介:Pong C Yuen received his Ph.D. degree in Electrical and Electronic Engineering in 1993 from The University of Hong Kong. He joined the Hong Kong Baptist University in 1993, and served as the Head of Department of Computer Science from 2011 – 2017. Currently, he is a Chair Professor at the Department of Computer Science and Associate Dean of Science Faculty, Hong Kong Baptist University. Dr. Yuen has been actively involved in many international conferences and professional community in the capacity of general/program co-chair, including ICPR 2006, BTAS 2012, ISBA 2016, WIFS 2018, IJCB 2021. He served as Associate Editor of IEEE Transactions on Information Forensics and Security (2014 – 2018, 2021-2022), and received the Outstanding Editorial Board Service Award in 2018. Dr. Yuen has served as the Vice President (Technical Activities) of the IEEE Biometrics Council (2017-2019), and Associate Editor/Senior Editor of SPIE Journal of Electronic Imaging (2012-2019). Currently, Dr. Yuen is serving as the Senior Area Editor of IEEE Transactions on Information Forensics and Security, Editorial Board Member of Pattern Recognition, and Associate Editor of IEEE Transactions on Biometrics, Behaviour and Identity Science. He received the first-prize and second-prize Natural Science Awards from the Guangdong Province and the Ministry of Education, China, respectively. He is a Fellow of IAPR. Dr. Yuen’s current research interests include biometric security and privacy, video surveillance and medical informatics.
报告简介:While face recognition technology has been extensive deployed in many practical applications, research problems on face presentation attack detection (PAD) are still unsolved. The popular face presentation attacks include images, videos and 3D masks. Among these, 3D mask presentation attack is the most challenging because high-quality 3D facial masks can be created at a reasonable cost. One of the promising approaches in addressing the 3D mask presentation attacks is remote photoplethysmography (rPPG). This talk will discuss the basic principle of using rPPG technology for face PAD, and the rPPG based face PAD methods. Since the reliability of rPPG based face PAD methods rely on the quality of estimated rPPG signals. This talk will also discuss the robustness of the rPPG estimation algorithms.
特邀报告2:ChatGPT浅析
特邀讲者:车万翔(哈尔滨工业大学计算学部,长聘教授)
讲者简介:车万翔,哈尔滨工业大学计算学部长聘教授/博士生导师,人工智能研究院副院长,教育部青年长江学者,龙江学者“青年学者”,斯坦福大学访问学者。现任中国中文信息学会理事、计算语言学专业委员会副主任兼秘书长;国际计算语言学学会亚太分会(AACL)执委兼秘书长。目前承担国家自然科学基金重点项目、2030“新一代人工智能”重大项目课题等多项科研项目。曾获AAAI 2013最佳论文提名奖。负责研发的语言技术平台(LTP)已被600余家单位共享,并授权给百度、腾讯、华为等公司使用。2016年获黑龙江省科技进步一等奖(排名第2),2020年获黑龙江省青年科技奖。
报告简介:2022年12月1日,OpenAI推出了全新一代的对话式人工智能工具——ChatGPT,因其表现出了惊艳的语言理解、生成以及知识推理等能力,获得了全网的热议和关注。ChatGPT的成功表现,使人们看到了解决自然语言处理这一认知智能核心问题的一条可能的路径,并被认为向通用人工智能目标迈出了坚实的一步,将对搜索引擎等应用构成巨大的挑战,甚至将取代很多人的工作,更将颠覆很多领域和行业。那么,ChatGPT究竟解决了什么科学问题,是如何解决该问题的,以及未来会还有哪些亟待解决的问题呢?希望通过本报告的粗浅分析,能部分回答以上的问题。
特邀报告3:联合掩码图像建模和对比学习的大规模预训练视觉基础模型研究
特邀讲者:王兴刚 (华中科技大学,教授)
讲者简介:王兴刚,华中科技大学,电信学院,教授,博士生导师。主要研究方向为视觉目标检测与分割,在IEEE TPAMI、IJCV、CVPR、ICML等顶级期刊会议发表学术论文50余篇,谷歌学术引用次数16000余次,在计算机视觉领域首次提出了空间稀疏自注意力机制(CCNet),该机制在Deepmind AlphaFold中应用,对应的论文在ICCV19最具影响力榜单上排名第五,引用超过1800次。担任Image and Vision Computing期刊共同主编,CVPR 2022、ICCV 2023领域主席,Pattern Recognition等期刊编委。入选了国家青年人才计划,中国科协青年人才托举工程,获CSIG青年科学家奖,CAAI吴文俊人工智能优秀青年奖,CVMJ 2021最佳论文奖,湖北省自然科学二等奖,华中科技大学青年五四奖章等,指导学生获2022年全国“互联网+”大赛金奖。
报告简介:以CLIP为代表的大规模预训练视觉基础模型将是未来计算机视觉发展的重要组件。为获取更好的预训练视觉基础模型,我们从掩码图像建模(MIM)和对比学习(CL)相结合的思路出发,做出了两个工作,均发表于CVPR 2023。第一个工作提出了一种新颖的在语言语义空间进行掩码重建 (RILS)的 预训练框架,RILS能够实现文本编码器和视觉编码器的协同增益,在同一个网络中融合CLIP和MIM二者的优点,在下游分类、检测和分割方面表现出优秀的可转移性。第二个工作提出了一个名叫EVA的视觉基础模型用以探索大规模视觉表征的极限,可以有效地将 EVA 扩展到 10 亿个参数,并在图像识别、视频动作识别、目标检测、实例分割和语义分割等广泛的具有代表性的视觉下游任务上创造新记录,而无需大量监督训练。 此外,EVA很大程度上解决了开放场景大类别实例分割问题,在1000类的LVIS数据集上取得了和80类COCO数据集几乎相同的业内领先性能。基于EVA我们推出EVA-CLIP,一个能够稳定高效训练且性能卓越的开源CLIP模型,且已经被Salesforce等公司使用。
主办单位:
中国图象图形学学会广州会员中心
广东省图象图形学会
华南理工大学电子与信息学院
承办单位:
华南理工大学电子与信息学院
中国图象图形学学会广州会员中心
广电运通金融电子股份有限公司
组委会:
赖剑煌、金连文、谢晓华,杨旭,薛洋
联系人:
金连文、薛洋(华南理工大学电子与信息学院)
Email: eelwjin@scut.edu.cn