广东省CVPR2025论文分享学术报告会于2025年4月26日成功召开,本次学术报告会由广东省图象图形学会(GDSIG)主办,由GDSIG计算机视觉专委会、CSIG广州会员活动中心、华南理工大学电子与信息学院、中山大学计算机学院联合承办。报告会由中山大学李冠彬教授、谢晓华教授、胡建芳副教授、王广润副教授共同主持,19位图象图形领域的优秀青年学子介绍了他们CVPR2025录用论文的最新研究成果,报告会在唯知科研WizSci、蔻享学术和GDSIG视频号三个平台进行了同步直播。来自全国各地的听众接近8000人次线上参加了本次学术报告会。
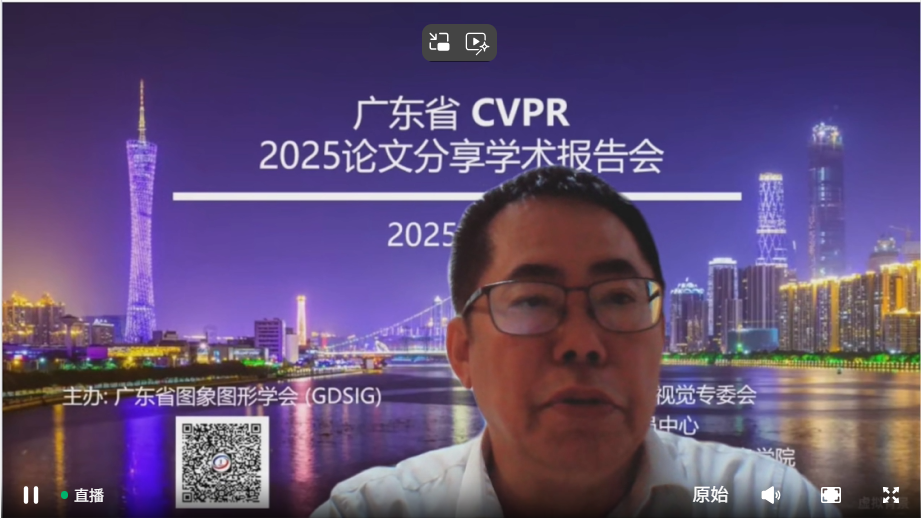
CSIG副理事长、CSIG广州会员活动中心主席赖剑煌教授开幕致辞
会议由中国图象图形学会(CSIG)副理事长、CSIG广州会员活动中心主席、中山大学赖剑煌教授致开幕词。赖教授对参与嘉宾、组织者及19位报告讲者表示欢迎与感谢。并表示CVPR是全球计算机视觉与人工智能领域极具影响力的顶级学术会议,引领行业潮流,对技术进步作用重大。本次报告会旨在促进大家深入了解CVPR2025优秀论文成果,推动学术交流与领域发展。今年CVPR录用率较低,为22.1%,连续三年下降,从13080篇投稿中录用2878篇,录用难度逐年增大。
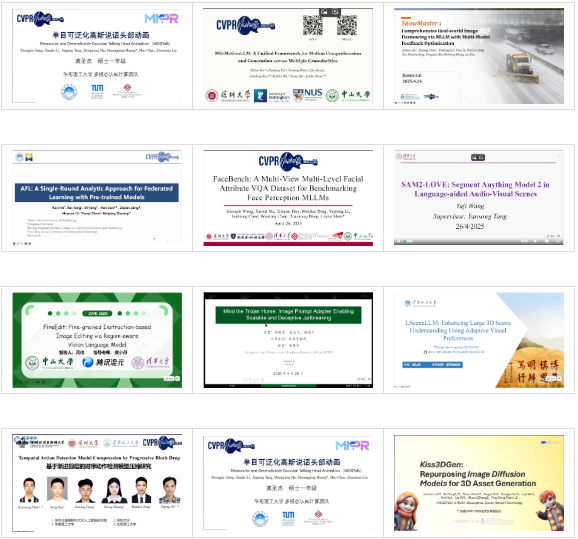
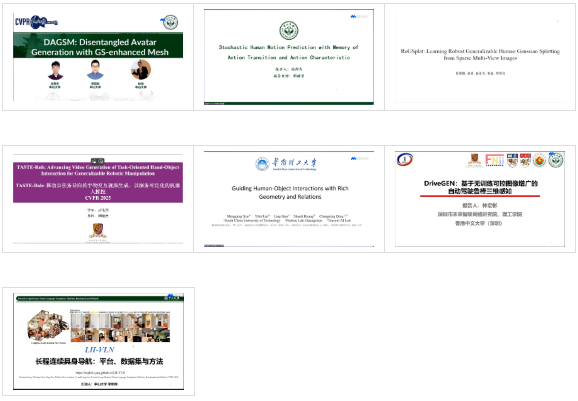
19位青年学子在会议期间分别围绕各自的研究成果,这些研究成果代表性地展示了广东学者在计算机视觉模式识别领域的学术风采和研究水平。
广东省图象图形学会理事长、华南理工大学金连文教授致闭幕辞
最后,大会在中国图象图形学学会常务理事、广东省图象图形学会理事长、CSIG文档图像分析与识别专委会主任、华南理工大学金连文教授的致辞中闭幕。金老师首先对带来本次精彩论文分享的19位同学、背后的指导老师与团队、本次会议组织者和主持人、直播平台以及听众表示了感谢。金老师总结到,今年分享的论文成果分为两个大的类别,涵盖了多模态、大模型、3D数字人、人机交互和自动驾驶等多个领域,并体现了这些领域的最新进展。根据最新的Google学术指标(Google Scholar Metrics),CVPR在全球学术出版物中排名第2,仅次于Nature。这一卓越成绩彰显了CVPR在学术领域的崇高地位与深远影响力。在此背景下,本次广东省CVPR学术论文分享会意义重大,充分展现广东在该领域研究方向的多元与前沿探索。未来活动或采用线下或线上线下结合形式,以促进面对面交流、拓展学术联系、推动学科发展。
我们诚挚期待更多优秀青年学子在计算机视觉领域取得突破,在未来报告会中积极参与,共促学术技术发展!
附1:报告论文列表
1.DocLayLLM: An Efficient Multi-modal Extension of Large Language Models for Text-rich Document Understanding
DocLayLLM:一种高效的多模态扩展大语言模型,用于文本丰富型文档理解
论文第一作者:廖文辉,汪诚愚 导师/通信作者:金连文
2.MG-MotionLLM: A Unified Framework for Motion Comprehension and Generation across Multiple Granularities
MG-MotionLLM:一个多粒度运动理解与生成的统一框架
论文第一作者:吴碧珠 导师/通信作者:任剑锋、沈琳琳
3.SnowMaster: Comprehensive Real-world Image Desnowing via MLLM with Multi-Model Feedback Optimization
SnowMaster:基于多模型反馈优化的MLLM全面真实图像去雪系统
论文第一作者:Jianyu Lai 导师/通信作者:朱磊
4.AFL: A Single-Round Analytic Approach for Federated Learning with Pre-trained Models
5.FaceBench: A Multi-View Multi-Level Facial Attribute VQA Dataset for Benchmarking Face Perception MLLMs
FaceBench:用于对人脸感知MLLM进行基准测试的多视图多级面部属性VQA数据集
6.SAM2-LOVE: Segment Anything Model 2 in Language-aided Audio-Visual Scenes
7.FireEdit: Fine-grained Instruction-based Image Editing via Region-aware Vision Language Model
FireEdit:基于区域感知视觉语言模型的细粒度指令图像编辑
8.Mind the Trojan Horse: Image Prompt Adapter Enabling Scalable and Deceptive Jailbreaking
注意特洛伊木马:图像提示适配器使大规模且误导性的越狱攻击成为可能
9.LSceneLLM: Enhancing Large 3D Scene Understanding Using Adaptive Visual Preferences
LSceneLLM:利用自适应视觉偏好增强大型3D场景理解
10.Temporal Action Detection Model Compression by Progressive Block Drop
论文第一作者:陈潇泳 导师/通信作者:曾润浩,国雍
11.Monocular and Generalizable Gaussian Talking Head Animation
12.Kiss3DGen: Repurposing Image Diffusion Models for 3D Asset Generation
Kiss3DGen:为3D资产生成而重塑图像扩散模型
论文第一作者:Xin Yang 导师/通信作者:陈颖聪
13.DAGSM: Disentangled Avatar Generation with GS-enhanced Mesh
论文第一作者:庄景宇 导师/通信作者:李冠彬、林倞
14.Stochastic Human Motion Prediction with Memory o
f Action Transition and Action Characteristic
15.RoGSplat: Learning Robust Generalizable Human Gaussian Splatting from Sparse Multi-View Images
RoGSplat:从稀疏视角图像学习鲁棒可泛化的人体高斯
论文第一作者:肖俊锦 导师/通信作者:郑伟诗、张青
16.TASTE-Rob: Advancing Video Generation of Task-Oriented Hand-Object Interaction for Generalizable Robotic
TASTE-Rob: 推动以任务导向的手物交互视频生成,以服务可泛化的机器人操控
17.Guiding Human-Object Interactions with Rich Geometry and Relations
18.DriveGEN: Generalized and Robust 3D Detection in Driving via Controllable Text-to-Image Diffusion Generation
19.Towards Long-Horizon Vision-Language Navigation: Platform, Benchmark and Method
论文第一作者:宋昕帅 导师/通信作者:刘阳,李冠彬
附2:会议回放链接
![]()